
| 일 | 월 | 화 | 수 | 목 | 금 | 토 |
|---|---|---|---|---|---|---|
| 1 | 2 | 3 | ||||
| 4 | 5 | 6 | 7 | 8 | 9 | 10 |
| 11 | 12 | 13 | 14 | 15 | 16 | 17 |
| 18 | 19 | 20 | 21 | 22 | 23 | 24 |
| 25 | 26 | 27 | 28 | 29 | 30 | 31 |
- openai
- Raspberry Pi Zero 2 W
- AI
- 디지털 카메라
- Freud
- 초기화
- MDAnalysis
- API
- GROMACS
- AABBQuery
- 깃허브(github)
- Maker
- Packmol
- LLM
- LNP
- CSS
- 깃(Git)
- mdvwhole
- 만들기
- HTML
- 원격 저장소
- Agent
- ssh
- 디카
- 깃허브
- Avogadro
- MD
- 깃
- mdvcontainment
- 자바스크립트
- Today
- Total
청관재(淸觀齋)
일지 #5 비동기 처리 및 오류 핸들링 (async / await / tenacity) 본문
수업 가기 전에 조금만 깔짝 해보려고 과학도서관에서 노트북과 책을 폈다.
아자아자....
# 비동기 프로그래밍
LLM API가 기존의 API와 다른 점은 최종 결과를 받기 전까지 시간이 많이 걸린다는 것이다.
또한 만약 요청이 연속적으로 발생한다고 가정한다면, 이전 요청이 끝나지 않았을 경우 뒤에 온 요청은 계속 기다려야 한다.
비동기 프로그래밍은 특정 작업이 완료될 때까지 시스템이 멈춰서 기다리지 않고, 곧바로 다음 코드를 실행하여 여러 작업을 유기적으로 동시에 진행할 수 있도록 하는 방식이다. 예를 들자면 앞사람의 커피가 다 만들어질 때까지 다른 사람이 주문조차 하지 못하고 카운터에서 기다리는 상황을 막는 것과 비슷할 것 같다.
LLM API를 서비스에 사용할 생각이라면 반드시 비동기 처리를 해야한다.
프로그래밍에서도 네트워크를 통해 서버에 데이터를 요청하거나 용량이 큰 파일을 읽는 등 시간이 오래 걸리는 작업을 할 때 비동기 방식을 사용한다.
이를 통해 프로그램이 멈추거나 지연되지 않고 화면 렌더링 등 다른 유용한 연산을 계속할 수 있어, 전체적인 애플리케이션의 응답 속도와 사용자 경험(UX)을 크게 향상시킬 수 있다.
또한 API가 장애 상태에 빠지거나 응답이 느려지는 경우도 있으니 이를 방지하기 위한 재시도 로직을 추가하는 것도 필요하다.
이번에는 비동기 작업을 위한 코드를 작성하고, 다음으로 재시도를 편하게 하기 위해 tenacity 라이브러리를 사용할 것이다.
# 1. async await를 사용하여 비동기 처리하기
파이썬에서는 async await 키워드를 사용하여 비동기 함수를 만들 수 있다.
사용법은 def 앞에 async를 넣고, 다른 비동기 함수에서 결괏값을 받는 부분에 await 키워드를 붙이는 것이다.
함수 선언 시에 async def [함수명](파라미터...): 와 같이 작성하고 이 함수를 사용하는 곳에서는 await [함수명] 으로 쓰면 된다.
import asyncio
import os

from openai import AsyncOpenAI
from anthropic import AsyncAnthropic


#1 비동기 클라이언트 생성
openai_client = AsyncOpenAI(api_key=os.environ.get("OPENAI_API_KEY"))
claude_client = AsyncAnthropic(api_key=os.environ.get("ANTHROPIC_API_KEY"))


async def call_async_openai(prompt: str, model: str = "gpt-5-mini") -> str:
    #2 await를 사용해 비동기적으로 API 응답을 기다림
    response = await openai_client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": prompt}],
    )

    return response.choices[0].message.content


async def call_async_claude(prompt: str, model: str = "claude-haiku-5-5") -> str:
    #3 await를 사용해 비동기적으로 API 응답을 기다림
    response = await claude_client.messages.create(
        model=model, max_tokens=1000, messages=[{"role": "user", "content": prompt}],
    )

    return response.content[0].text


async def main():
    print("동시에 API 호출하기")
    prompt = "비동기 프로그래밍에 대해 두세 문장으로 설명해주세요."
    #4 비동기 함수 호출 시 코루틴 객체 반환(실행은 아직 안 됨)
    openai_task = call_async_openai(prompt)
    claude_task = call_async_claude(prompt)

    #5 두 API 호출을 병렬로 실행하고 둘 다 완료될 때까지 대기
    openai_response, claude_response = await asyncio.gather(openai_task, claude_task)
    print(f"OpenAI 응답: {openai_response}")
    print(f"Claude 응답: {claude_response}")


if __name__ == "__main__":
    asyncio.run(main())    #6 비동기 메인 함수를 이벤트 루프에서 실행
이렇게 책에 나와있는 코드를 입력하고 실행하면 오류가 뜬다.
raise OpenAIError("The api_key client option must be set either by passing api_key to the client or by setting the OPENAI_API_KEY environment variable")
openai.OpenAIError: The api_key client option must be set either by passing api_key to the client or by setting the OPENAI_API_KEY environment variable
이 문제는 .env에 저장한 API 키를 읽지 못해서 발생한 문제이다.
지금 해당 코드에는 load_dotenv() 가 없어서 맨 위에 코드 두 줄을 추가해준다.
dotenv는 .env 파일에 저장된 환경 변수(API 키, 설정 등)를 자동으로 로드해주어, 코드 내에 민감 정보를 하드코딩하지 않도록 돕는 유틸리티이다.
from dotenv import load_dotenv

load_dotenv()  # .env 파일에서 환경 변수 로드
위 코드를 추가해주고 실행하면 정상적으로 답변이 출력된다.
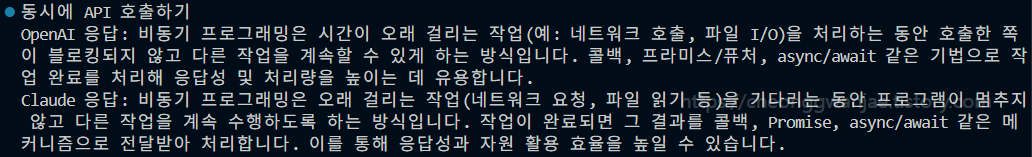
코드를 자세히 살펴보자.
- 비동기 클라이언트 생성
#1 비동기 클라이언트 생성
openai_client = AsyncOpenAI(api_key=os.environ.get("OPENAI_API_KEY"))
claude_client = AsyncAnthropic(api_key=os.environ.get("ANTHROPIC_API_KEY"))
오픈AI와 앤트로픽의 모델은 모두 비동기 클래스를 지원하며 각각 AsyncOpenAI, AsynAnthropic이다.
해당 클래스를 사용해 비동기 API 클라이언트를 초기화한다.
api_key 파라미터에는 각 LLM 제공자의 API 키가 필요하다.
OPENAI_API_KEY, ANTHROPIC_API_KEY 변수명은 API 키를 할당하지 않을 때 기본적으로 가져오는 값이다.
- await를 사용해 비동기적으로 API 응답을 기다림
#2 await를 사용해 비동기적으로 API 응답을 기다림
response = await openai_client.chat.completions.create(
    model=model,
    messages=[{"role": "user", "content": prompt}],
)
#3 await를 사용해 비동기적으로 API 응답을 기다림
response = await claude_client.messages.create(
model=model, max_tokens=1000, messages=[{"role": "user", "content": prompt}],
)
두 API 호출 함수에서 await 키워드를 사용한다.
이 키워드는 비동기 작업이 완료될 때까지 기다리지만, 그 동안 이벤트 루프는 다른 작업을 수행할 수 있다.
즉, API 응답을 기다리는 동안 프로그램의 응답이 차단되지 않는다.
- 비동기 함수 호출 시 코루틴 객체 반환 (실행은 아직 안 됨)
#4 비동기 함수 호출 시 코루틴 객체 반환(실행은 아직 안 됨)
openai_task = call_async_openai(prompt)
claude_task = call_async_claude(prompt)
비동기 함수를 호출할 때는 즉시 실행되지 않고 코루틴 객체를 반환한다.
(해당 객체들은 나중에 실행 예정인 작업임)
- 두 API 호출을 병렬로 실행하고 둘 다 완료될 때까지 대기
#5 두 API 호출을 병렬로 실행하고 둘 다 완료될 때까지 대기
openai_response, claude_response = await asyncio.gather(openai_task, claude_task)
print(f"OpenAI 응답: {openai_response}")
print(f"Claude 응답: {claude_response}")
asyncio.gather() 는 여러 코루틴을 동시에 실행하고 모든 결과를 기다린다.
두 API 가 동시에 호출되어 병렬로 실행되므로 시간이 절약된다.
순차적으로 실행할 경우 두 응답 시간의 합만큼 걸렸겠지만, 이렇게 하면 gather에 넣은 코루틴 중에 가장 오래 걸린 응답 시간만큼만 걸린다.
- 비동기 메인 함수를 이벤트 루프에서 실행
asyncio.run(main())
asyncio.run() 은 비동기 함수를 실행하기 위한 코드다.
await main() 으로 쓸 수 없는 이유는, await는 함수 내에서만 사용할 수 있기 때문이다.
메인 진입점에서는 asyncio.run(<함수실행>) 을 실행함으로써 비동기 함수를 실행할 수 있다.
# 2. 간헐적으로 실패하는 함수 만들기
LLM API를 많이 사용하다 보면 실패율이 생각보다 높다는 것을 알게된다. 사용 시에는 재시도가 필수다.
실패하면 다시 시도하는 로직로 좋지만, tenacity라는 라이브러리를 사용하면 에러 발생 시의 재시도를 매우 쉽게 구현할 수 있다.
먼저 아래 명령을 실행하여 tenacity를 설치해준다.
pip install tenacity==8.2.3
다음으로 테스트를 위해 확률적으로 에러를 발생시키는 함수를 만들고, logger를 사용해서 에러 로그도 찍는다.
tenacity에서 사용할 메서드도 미리 임포트 시킨다.
import asyncio
import os
import logging
import random
from dotenv import load_dotenv
from openai import AsyncOpenAI
from anthropic import AsyncAnthropic
from tenacity import retry, stop_after_attempt, wait_exponential, retry_if_exception_type
load_dotenv() # .env 파일에서 환경 변수 로드
# 로깅 설정
logging.basicConfig(level=logging.INFO)
logger = logging.getLogger(__name__)
#1 비동기 클라이언트 생성
openai_client = AsyncOpenAI(api_key=os.environ.get("OPENAI_API_KEY"))
claude_client = AsyncAnthropic(api_key=os.environ.get("ANTHROPIC_API_KEY"))
# 테스트용 간헐적 실패 시뮬레이션 함수
async def simulate_random_failure():
# 50% 확률로 실패 발생시키기
if random.random() < 0.5:
logger.warning("인위적으로 API 호출 실패 발생 (테스트용)")
raise ConnectionError("인위적으로 발생시킨 연결 오류 (테스트용)")
# 약간의 지연시간 추가
await asyncio.sleep(random.uniform(0.1, 0.5))
async def call_async_openai(prompt: str, model: str = "gpt-5-mini") -> str:
#2 await를 사용해 비동기적으로 API 응답을 기다림
response = await openai_client.chat.completions.create(
model=model,
messages=[{"role": "user", "content": prompt}],
)
return response.choices[0].message.content
async def call_async_claude(prompt: str, model: str = "claude-haiku-5-5") -> str:
#3 await를 사용해 비동기적으로 API 응답을 기다림
response = await claude_client.messages.create(
    model=model, max_tokens=1000, messages=[{"role": "user", "content": prompt}],
)
return response.content[0].text
async def main():
print("동시에 API 호출하기")
prompt = "비동기 프로그래밍에 대해 두세 문장으로 설명해주세요."
#4 비동기 함수 호출 시 코루틴 객체 반환(실행은 아직 안 됨)
openai_task = call_async_openai(prompt)
claude_task = call_async_claude(prompt)
#5 두 API 호출을 병렬로 실행하고 둘 다 완료될 때까지 대기
openai_response, claude_response = await asyncio.gather(openai_task, claude_task)
print(f"OpenAI 응답: {openai_response}")
print(f"Claude 응답: {claude_response}")
if __name__ == "__main__":
asyncio.run(main()) #6 비동기 메인 함수를 이벤트 루프에서 실행
async def로 선언되어 있어서 다른 곳에서 호출 시 await를 함께 붙여줘야 한다.
random.random() 은 0과 1 사이의 난수를 생성한다. 값이 0.5보다 작으면 에러를 발생시킨다. (50% 확률)
에러 발생 시에는 logger.warning으로 로그를 남겨 주었고, 에러는 ConnectionError를 사용했다.
await asyncio.sleep(random.uniform(0.1, 0.5) 는 에러가 발생하지 않을 경우 0.1 ~ 0.5초 사이의 지연을 준다.
이 코드는 네트워크 지연이나 처리 시간의 변동을 시뮬레이션하는 용도이다.
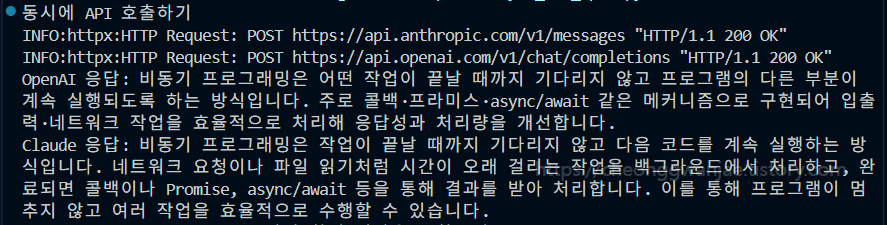
실행 결과는 아래와 같다.
# 3. tenacity를 적용하여 재처리하기
이제 tenacity를 적용할 준비가 마무리되었으므로 나머지 코드들을 구현한다.
import asyncio
import os
import logging
import random

from dotenv import load_dotenv
from openai import AsyncOpenAI
from anthropic import AsyncAnthropic
from tenacity import retry, stop_after_attempt, wait_exponential, retry_if_exception_type


load_dotenv()  # .env 파일에서 환경 변수 로드

# 로깅 설정
logging.basicConfig(level=logging.INFO)
logger = logging.getLogger(__name__)

# 비동기 클라이언트 생성
openai_client = AsyncOpenAI(api_key=os.environ.get("OPENAI_API_KEY"))
claude_client = AsyncAnthropic(api_key=os.environ.get("ANTHROPIC_API_KEY"))


# 테스트용 간헐적 실패 시뮬레이션 함수
async def simulate_random_failure():
    # 50% 확률로 실패 발생시키기
    if random.random() < 0.5:
        logger.warning("인위적으로 API 호출 실패 발생 (테스트용)")
        raise ConnectionError("인위적으로 발생시킨 연결 오류 (테스트용)")
    # 약간의 지연시간 추가
    await asyncio.sleep(random.uniform(0.1, 0.5))


#1 tenacity를 사용한 재시도 데코레이터 적용
@retry(
        stop=stop_after_attempt(3),  # 최대 3회 재시도
        wait=wait_exponential(multiplier=1, min=2, max=10),  # 지수적 백오프: 2초, 4초, 8초...
        retry=retry_if_exception_type(),    # 모든 예외에 대해 재시도
        before_sleep=lambda retry_state: logger.warning(
            f"API 호출 실패: {retry_state.outcome.exception()}, {retry_state.attempt_umber}번째 재시도 중..."
        )
)


async def call_async_openai(prompt: str, model: str = "gpt-5-mini") -> str:
    #2 랜덤한 확률로 실패하는 call_async_openai 함수
    # await를 사용해 비동기적으로 API 응답을 기다림
    logger.info(f"OpneAI API 호출 시작: {model}")

    # 테스트를 위한 랜덤 실패 시뮬레이션
    await simulate_random_failure()


    response = await openai_client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": prompt}],
    )
    logger.info(f"OpneAI API 호출 성공")

    return response.choices[0].message.content


async def call_async_claude(prompt: str, model: str = "claude-haiku-5-5") -> str:
    logger.info(f"Claude API 호출 시작: {model}")
    response = await claude_client.messages.create(
        model=model, max_tokens=1000, messages=[{"role": "user", "content": prompt}],
    )

    return response.content[0].text


async def main():
    print("동시에 API 호출하기")
    prompt = "비동기 프로그래밍에 대해 두세 문장으로 설명해주세요."
    #4 비동기 함수 호출 시 코루틴 객체 반환(실행은 아직 안 됨)
    openai_task = call_async_openai(prompt)
    claude_task = call_async_claude(prompt)

    try:
        # gather는 전체 작업 중 하나라도 실폐하면 예외 발생
        openai_response, claude_response = await asyncio.gather(
            openai_task, claude_task, return_exceptions=False
        )
        print(f"OpenAI 응답: {openai_response}")
        print(f"Claude 응답: {claude_response}")
    except Exception as e:
        logger.error(f"API 호출 중 처리되지 않은 오류 발생: {e}")


if __name__ == "__main__":
    asyncio.run(main())
기존 코드에 try except를 사용한 오류 처리와 tenacity를 사용한 재시도 기능이 추가되었다.
추가된 기능은 아래와 같다.
1. tenacity를 사용한 재시도 데코레이터 적용 (오픈AI 함수)
#1 tenacity를 사용한 재시도 데코레이터 적용
@retry(
        stop=stop_after_attempt(3),  # 최대 3회 재시도
        wait=wait_exponential(multiplier=1, min=2, max=10),  # 지수적 백오프: 2초, 4초, 8초...
        retry=retry_if_exception_type(),    # 모든 예외에 대해 재시도
        before_sleep=lambda retry_state: logger.warning(
            f"API 호출 실패: {retry_state.outcome.exception()}, {retry_state.attempt_umber}번째 재시도 중..."
        )
)
함수가 실패했을 때 재시도하는 기능을 만드는 것은 쉽지만 코드가 깔끔하지 못하다.
tenacity에서는 재시도 메커니즘 고나련한 거의 대부분의 코드를 만들어두었기 때문에 가져다 쓰면 된다.
위의 코드에서는 재시도를 하기 위해 @retry 데코레이터를 사용했다.
데코레이터 안에는 stop, wait, retry, before_sleep 이라는 파라미터가 있고 각각의 의미는 다음과 같다.
- stop=stop_after_attempt(3) : 최대 3번까지만 시도
- wait=wait_exponential(...) : 재시도 간격이 지수적으로 증가하는 백오프 전략을 사용. 2의 1승부터 점차 증가.
- retry=retry_if_exception_type() : 모든 종류의 예외가 발생했을 때 재시도
- before_sleep : 재시도 전의 동작을 추가할 수 있음. 위 코드에서는 로그를 남겨서 현재 상태와 예외 정보를 기록함.
2. 랜덤한 확률로 실패하는 call_async_openai 함수
async def call_async_openai(prompt: str, model: str = "gpt-5-mini") -> str:
    #2 랜덤한 확률로 실패하는 call_async_openai 함수
    # await를 사용해 비동기적으로 API 응답을 기다림
    logger.info(f"OpneAI API 호출 시작: {model}")

    # 테스트를 위한 랜덤 실패 시뮬레이션
    await simulate_random_failure()


    response = await openai_client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": prompt}],
    )
    logger.info(f"OpneAI API 호출 성공")

    return response.choices[0].message.content
simulate_random_failure() 를 호출 시 50%의 확률로 ConnectionError가 발생함.
try-except 블록으로 오류를 포착하고 로깅한 후 다시 던져서 재시도 메커니즘이 작동하게 됨.
3. gather는 전체 작업 중 하나라도 실패하면 예외 발생
try:
    #3 gather는 전체 작업 중 하나라도 실폐하면 예외 발생
    openai_response, claude_response = await asyncio.gather(
        openai_task, claude_task, return_exceptions=False
    )
    print(f"OpenAI 응답: {openai_response}")
    print(f"Claude 응답: {claude_response}")
except Exception as e:
    logger.error(f"API 호출 중 처리되지 않은 오류 발생: {e}")
return_exceptions=False 파라미터로 인해 asyncio.gather() 는 어느 하나의 태스크라도 예외가 발생하면 전체 작업이 실패함.
외부 try-except 블록을 사용하여 이런 전체 실패를 처리하고 로깅함.
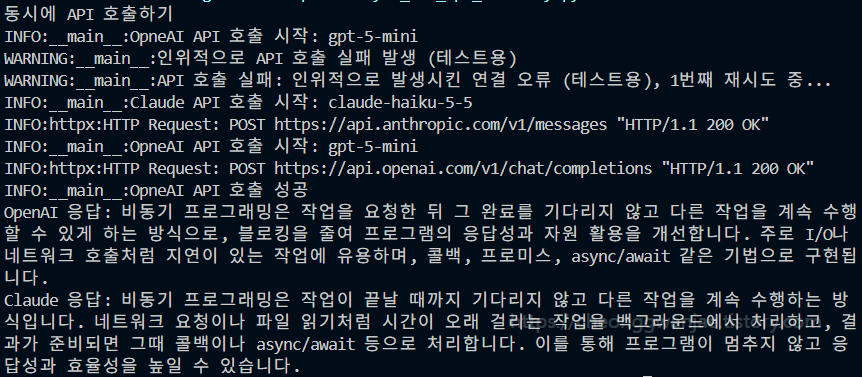
실행을 하면 다음과 같이 실패 시 재시도하는 로그가 남게 된다.
아 힘들어 뒤지겠다.
오늘은 여기서 마무리...
~~~ 끗 ~~~
'무한도전!! > Agent-ai 마스터하기!!' 카테고리의 다른 글
| 일지 #4 Anthropic API 사용법 / 스트리밍(streaming) 처리 (0) | 2026.10.22 |
|---|---|
| 일지 #3 OpenAI API 사용법 (챗 컴플리션 API / 리스폰스 API) (0) | 2026.10.19 |
| 일지 #2 깃 환경 초기화 / 로컬 저장소와 원격 저장소(GitHub) 연결하기 / LLM과 랭체인(LangChain) 개발 (0) | 2026.10.18 |
| 일지 #1 깃/깃허브로 문서 관리하기 (0) | 2026.10.13 |


