
| 일 | 월 | 화 | 수 | 목 | 금 | 토 |
|---|---|---|---|---|---|---|
| 1 | 2 | 3 | ||||
| 4 | 5 | 6 | 7 | 8 | 9 | 10 |
| 11 | 12 | 13 | 14 | 15 | 16 | 17 |
| 18 | 19 | 20 | 21 | 22 | 23 | 24 |
| 25 | 26 | 27 | 28 | 29 | 30 | 31 |
- 초기화
- 유기화학(Organic Chemistry)
- 고급유기화학(Advanced Organic Chemistry)
- GROMACS
- 깃허브
- 깃허브(github)
- Packmol
- LNP
- 자바스크립트
- 깃(Git)
- MD
- deploy key
- Oxy-Cope
- Avogadro
- Entropic
- Chat Completion API
- LLM
- Simmons-Smith
- AI
- 원격 저장소
- Favorskii
- Response API
- 깃
- Nazarov
- API
- Martini 3
- openai
- Beckmann
- HTML
- CSS
- Today
- Total
청관재(淸觀齋)
일지 #4 Anthropic API 사용법 / 스트리밍(streaming) 처리 본문
클로드는 매우 자연스러운 한국어 대화를 생성한다.
클로드를 사용하려면 anthropic 패키지를 설치해야 한다.
pip install anthropic==0.49.0
위 명령으로 의존성 패키지를 설치해준다.
(꼭 .venv 환경이 활성화 되어있어야 한다.)
앤트로픽 API 사용법은 오픈AI의 챗 컴플리션 API와 거의 같다.
이번에는 이전 대화를 유지하는 예제를 공부할 계획이다.
먼저 이전에 진행했던 것처럼 .env 파일에 ANTHROPIC_API_KEY를 등록해주는 과정이 필요하다.
이제 아래 코드를 chapter1 폴더에 hello_anthropic.py 파일명으로 저장해준다.
import os
from dotenv import load_dotenv
import anthropic

#1 .env 파일에서 환경 변수 로드
load_dotenv()


#2 Anthropic API 키 가져오기
api_key = os.environ.get('ANTHROPIC_API_KEY')

client = anthropic.Anthropic()


#3 대화 기록을 저장할 리스트
conversation = []

# 사용자 입력 추가
conversation.append({"role": "user", "content": "안녕 나는 청관이야."})


#4 클로드 호출
response = client.messages.create(
    model="claude-haiku-5-5",
    max_tokens=1000,
    messages=conversation
)


#5 응답 출력 및 대화 기록에 추가
assistant_message = response.content[0].text
print(assistant_message)
conversation.append({"role": "assistant", "content": assistant_message})


#6 다음 사용자 입력
conversation.append({"role": "user", "content": "내 이름이 뭐라고?"})

# 다시 클로드 호출
response = client.messages.create(
    model="claude-haiku-5-5",
    max_tokens=1000,
    messages=conversation
)


#7 두 번째 응답 출력
print(response.content[0].text)
교재에 있는 코드에서 몇가지를 더 추가하여 작성하였다.
환경변수 로드에 필요한 코드라던지, 더 이상 지원하지 않는 모델 문제가 있어서 수정해주었다.
[F5] 로 실행하면 다음과 같이 출력된다.
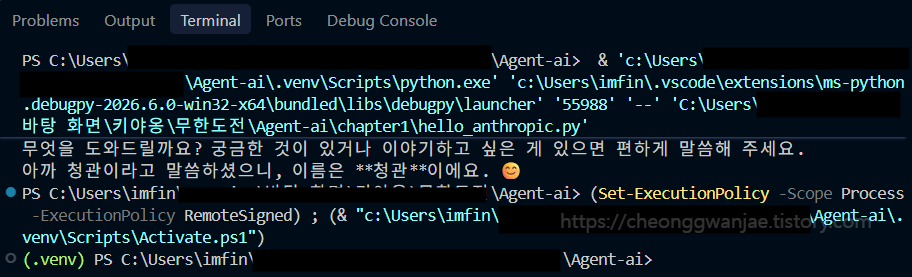
처음 대화에서 이름을 알려주고 그 정보를 기억하여 두 번째 질문에서 이름을 기억해서 말해준다.
대화 기록은 conversation이라는 이름의 리스트를 생성하여 저장된다. 클로드 AI 모델에서 리스트를 사용하여 대화의 히스토리를 관리할 수 있다. 이는 클로드가 이전 대화 맥락을 기억할 수 있게 한다.
이번 예제에서는 함수도 없고 'if __name__'도 없다.
이렇게 스크립트 방식으로 사용하는 것도 문제가 없지만, 다른 파일에서 모듈로 가져와 사용하는 경우, 지금처럼 스크립트 형태로 작성하면 임포트 시 코드가 실행되므로 권장되진 않는다.
# 스트리밍 처리
LLM API는 일반적으로 요청에 대한 응답을 두 가지 형태로 제공한다.
1) 요청에 대한 응답을 한 번에 반환하기
2) 결괏값을 계속 흘려보내는 방식
후자의 경우를 스트리밍(streaming) 방식이라고 하는데, LLM의 응답은 오래 걸리거나 길게 나오는 경우가 많으므로 유저와 상호작용이 필요한 서비스에서 사용하면 좋다.
# OpenAI의 스트리밍 처리
대부분의 모델이 스트리밍 옵션을 지원하며, 기존 코드에 stream=True만 추가하면 요청에 대한 결과가 즉시 토큰 단위로 반환된다.
이번 예제에서는 콘솔에서 오브젝트 출력 시 더 예쁘게 출력하는 rich 라이브러리를 사용할 것이다.
아래 명령 코드를 통해서 설치할 수 있다.
pip install rich==14.0.0
아래 코드를 chapter1 폴더에 hello_openai_streaming.py 파일명으로 저장한다.
from dotenv import load_dotenv
from openai import OpenAI
import rich

load_dotenv()
client = OpenAI()

default_model = "gpt-5-mini"


def stream_chat_completion(prompt, model):
    #1 chat.completions API를 사용한 스트리밍 응답 함수
    stream = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": prompt}],
        stream=True     #2 스트리밍 모드 활성화
    )
    for chunk in stream:    #3 응답 청크(조각)를 하나씩 처리
        content = chunk.choices[0].delta.content
        if content is not None:
            print(content, end="")


def stream_response(prompt, model):
    #4 새로운 리스폰스 API를 사용한 스트리밍 함수(컨텍스트 매니저로 스트림 관리)
    with client.responses.stream(model=model, input=prompt) as stream :
        for event in stream:    #5 스트림에서 발생하는 각 이벤트 처리
            if "output_text" in event.type:     #6 텍스트 출력 이벤트인 경우
                rich.print(event)
    rich.print(stream.get_final_response())


if __name__ == "__main__":
    stream_chat_completion("스트리밍이 뭔가요?", default_model)
    stream_response("점심 메뉴 추천 해주세요.", default_model)
- rich 라이브러리 미사용 버전 코드
출력 결과는 아래와 같다.
(좌) rich 라이브러리 사용 / (우) rich 라이브러리 미사용 으로 비교해 보았다.
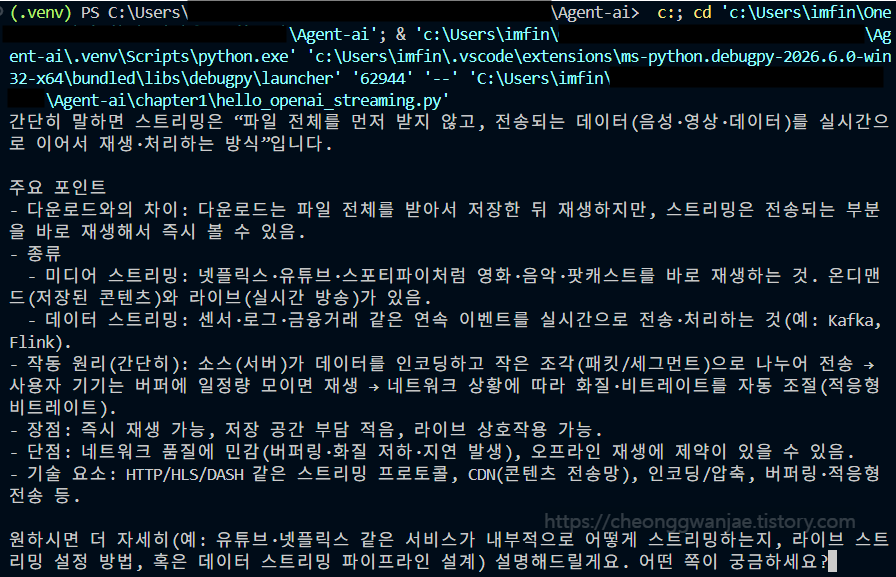

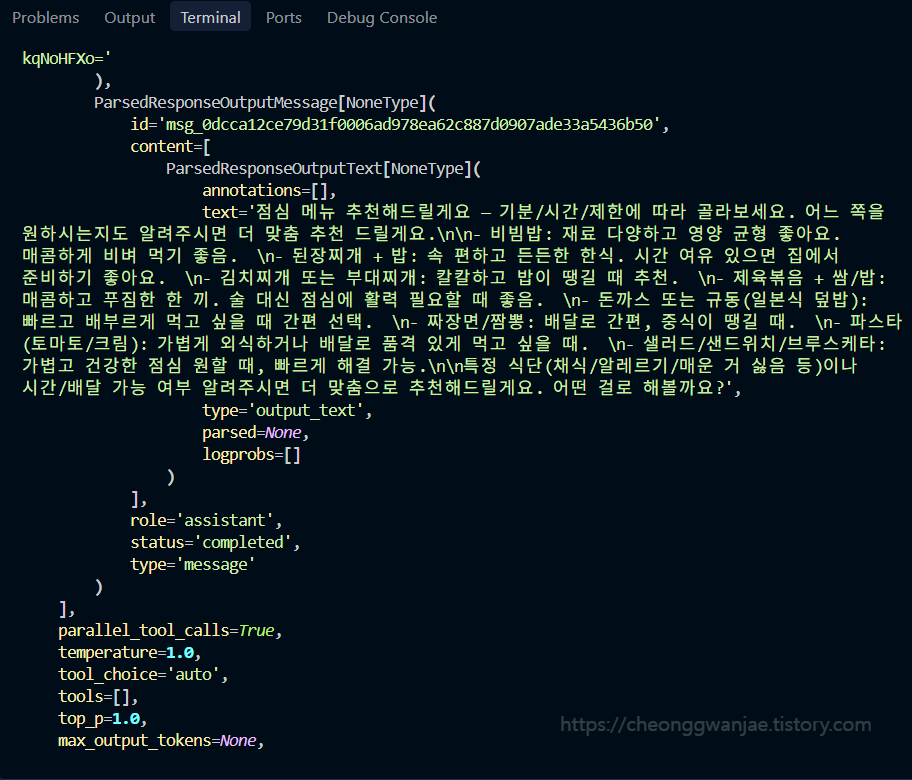
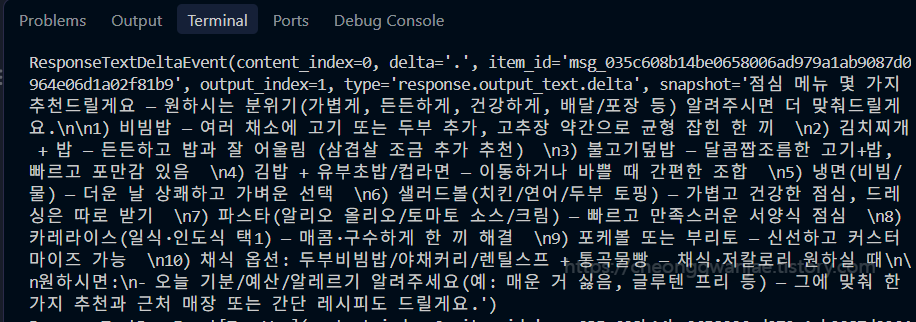
크게 별 차이 없는 것 같다....
stream=True 파라미터를 사용하여 스트리밍 모드를 활성화 했다.
스트림 모드가 활성화되면 응답이 청크(조각)으로 나뉘어 순차적으로 도착하게 된다.
각 청크에서 delta.content를 추출하여 출력한다. print 문에서 end="" 옵션을 주면 줄바꿈 없이 청크들을 연결하여 자연스럽게 텍스트가 출력된다.
# Anthropic 의 스트리밍 처리
앤트로픽 API는 stream 메서드를 별도로 제공하고 with를 사용한 컨텍스트 매니저 기능도 제공한다.
오픈AI의 리스폰스 API에서 제공하는 stream 메서드와 사용법이 유사하다.
아래 코드를 chapter1 폴더에 hello_anthropic_streaming.py로 저장한다.
import anthropic
import rich


client = anthropic.Anthropic()

prompt = "anthropic 발음은 앤트로픽이 맞나요? 앤스로픽이 맞나요?"

with client.messages.stream(    #1 컨텍스트 매니저를 사용한 스트리밍 세션 생성
    max_tokens=1024,
    messages=[{"role": "user", "content": prompt}],
    model="claude-haiku-5-5",
) as stream:
    for event in stream:
        if event.type == "text":    #2 텍스트 타입 이벤트만 처리
            print(event.text, end="")
    print()
    #3 최종 응답 출력
    rich.print(stream.get_final_message())
이제 [F5]로 실행해줬더니 TypeError가 떴다..!
TypeError: "Could not resolve authentication method. Expected either api_key or auth_token to be set. Or for one of the `X-Api-Key` or `Authorization` headers to be explicitly omitted"
보니깐 API 인증 관련 에러인 것 같다.
코드에 이 부분을 추가해주면 된다.
import os

# Anthropic API 키 가져오기
api_key = os.environ.get('ANTHROPIC_API_KEY')
수정된 전체 코드는 아래와 같다.
import os
import anthropic
import rich

# Anthropic API 키 가져오기
api_key = os.environ.get('ANTHROPIC_API_KEY')

client = anthropic.Anthropic()

prompt = "anthropic 발음은 앤트로픽이 맞나요? 앤스로픽이 맞나요?"

with client.messages.stream(    #1 컨텍스트 매니저를 사용한 스트리밍 세션 생성
    max_tokens=1024,
    messages=[{"role": "user", "content": prompt}],
    model="claude-haiku-5-5",
) as stream:
    for event in stream:
        if event.type == "text":    #2 텍스트 타입 이벤트만 처리
            print(event.text, end="")
    print()
    #3 최종 응답 출력
    rich.print(stream.get_final_message())
출력은 다음과 같다.
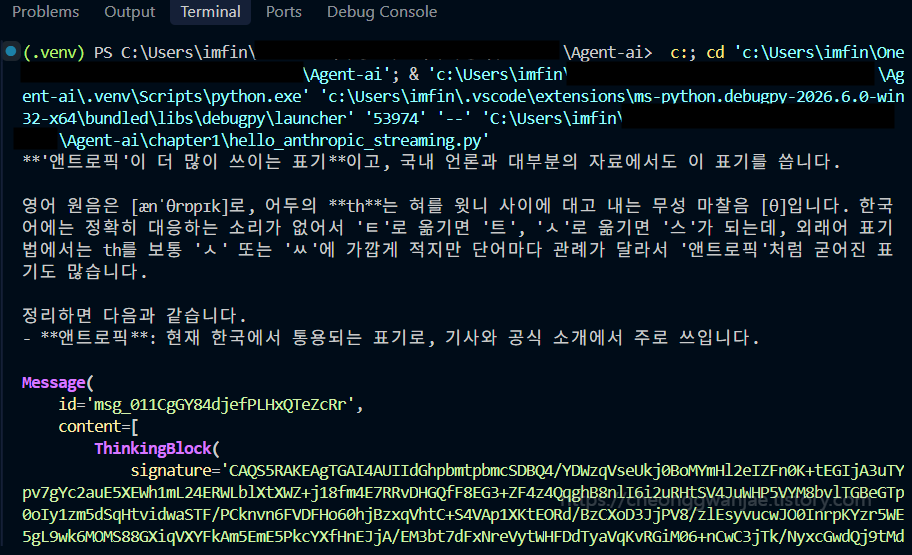
엔트로픽은 오픈AI 보다 응답이 더 간결하다는 것을 확인할 수 있다.
아.. 힘들어...
오늘은 여기까지....;;;;
'무한도전!! > Agent-ai 마스터하기!!' 카테고리의 다른 글
| 일지 #3 OpenAI API 사용법 (챗 컴플리션 API / 리스폰스 API) (0) | 2026.10.19 |
|---|---|
| 일지 #2 깃 환경 초기화 / 로컬 저장소와 원격 저장소(GitHub) 연결하기 / LLM과 랭체인(LangChain) 개발 (0) | 2026.10.18 |
| 일지 #1 깃/깃허브로 문서 관리하기 (0) | 2026.10.13 |


