[LNP] Step3_hexagon_channels
이제 드디어 Step3에 도달했다....
또 열심히 달려보자...
Step3는 Step2에서 만든 채널 구조(m.gro)를 복제한 뒤, 그 안에서 육각형 배열을 이루는 채널 묶음만 골라내는 단계를 진행한다.
이는 크게 세 부분으로 나눌 수 있다.
1. 채널 복제
- gmx gencof -nbox 4 4 1 로 m.gro 를 x,y 방향으로 4X4 복제해서 4x4x1_channels.pdb를 만든다.
- 물 / 이온 / RNA 비드(W WF ION NA CL BB* SC*) 중에서 지질 꼬리 비드 (CA1 CB1 C3A C3B D3A D3B) 8 Å 이내에 있는 것은 빼고 선택한다. 이렇게 하면 채널 안쪽의 순수한 용매 영역만 남는다.
- mdvcontainment 으로 포함관계를 분석해서 채널이 64개로 제대로 분리되는지 containers.plot() 으로 확인한다.
2. 모든 원자에 채널 ID 붙이기
- containment 결과를 두 종류로 나눈다. 바깥쪽(root)은 지질 컴포넌트, 나머지는 각 채널에 해당되는 용매 컴포넌트다.
- 선택되지 않은 나머지 원자(지질과 지질 근처 용매)마다 freud AABBQuery 로 가장 가까운 용매 원자를 찾는다 (PBC 고려). 그 원자가 속한 채널 ID를 해당 원자에 붙인다.
- 한 residue(지질 분자)rk wndrksdp wkfflwl dksgehfhr, residue 안의 원자들이 가장 많이 가리키는 채널 ID 하나로 residue 전체를 통일한다 (다수결).
- 결과는 clusters.npy, components.pdb 두 가지로 저장한다. clusters.npy는 프레임별 라벨 배열로, mdvwhole에서 쓰는 형식이다. components.pdb는 각 원자의 beta(tempfactor) 필드에 채널 ID를 기록한 PDB이다.
3. 육각형 채널 선택
- components.pdb를 VMD나 Chimera에 불러와 beta 값으로 색을 입힌다.
- 육각형을 이루는 채널들을 beta 값으로 선택해서 Hexagon.pdb로 저장한다.
정리하자면, 채널을 4x4로 복제하고, 모든 원자에 "어느 채널 소속인지" 라벨을 붙인 다음, 시각화 도구에서 육각형 모양의 채널 묶음을 직접 골라 Hexagon.pdb로 저장한다. 그리고 이 파일이 step4(토폴로지 생성)의 입력이 된다.
# 라이브러리 불러오기
import numpy as np
import MDAnalysis as mda
import mdvcontainment as mdvc
import freud
이 셀은 step3에서 쓰는 라이브러리 4개를 불러오는 import 셀이다.
| 라이브러리 | 역할 |
| MDAnalysis | 구조 읽기, 원자 선택, PDB 쓰기 |
| mdvcontainment | 채널을 컴포넌트로 자동 ㅇ분리하고 ID 부여 |
| freud | 나머지 원자에 가장 가까운 채널을 빠르게 찾기 |
| numpy | 라벨 배열 처리와 clusters.npy 저장 |
1. import numpy as np
파이썬의 기본 수치 계산 라이브러리이고, 배열 연산을 담당한다.
- freud가 반환한 이웃 쌍을 배열로 바꾼다.
- 가장 가까운 용매 원자 인덱스를 채널 ID로 한꺼번에 바꾼다.
- 전체 원자 수만큼의 라벨 배열을 만든다.
- 채널 ID별 원자 수를 세서 확인한다.
- 최종 라벨 배열을 저장한다.
2. import MDAnalysis as mda
MD 구조/궤적 파일(PDB, GRO, XTC 등)을 읽고, 원자를 선택하고, 파일로 쓰는 라이브러리다.
- Universe : 구조 전체(원자, residue, 박스 크기)를 담는 객체
- AtomGroup : 원자들의 부분집합. +, - 같은 집합 연산을 할 수 있음
- 복제된 구조를 읽는다.
- VMD와 비슷한 선택 문법으로 채널 용매만 고른다.
- 선택되지 않은 나머지 원자(지질과 지질 근처 용매)를 구한다.
- 원자의 전역 인덱스를 표현한다.
- residue 단위로 순회하면서 다수결을 할 때 사용한다.
- 박스 크기를 PBC 처리에 넘겨준다.
- 채널 ID를 beta 필드에 넣고 PDB로 저장한다.
3. import mdvcontainment as mdvc
MD 구조 안에서 "어떤 영역이 어떤 영역을 감싸고 있는지(containment)"를 PBC까지 고려해 분석하는 라이브러리로 MDVoxelSegmentation 계열의 도구이다.
작동 방식은 선택한 원자들을 복셀(3D 격자)로 바꾸고, 연결된 덩어리(component)로 나눈 다음, 서로 감싸는 관계를 그래프(containment graph)로 만든다.
- 채널 용매를 기준으로 containment 분석을 실행한다.
- 포함 관계 그래프를 그려서 채널이 64개인지 확인한다.
- 전체 컴포넌트, 가장 바깥(지질 영역) 컴포넌트, 특정 컴포넌트의 자식을 구한다.
- 그래프의 각 노드에 붙어있는 AtomGroup을 꺼낸다.
- 박스 정보를 freud가 쓰는 Box 객체로 바꾼다.
이 라이브러리 덕분에 "채널 하나 = 컴포넌트 하나"로 자동 분리되지 않고, 각 컨포넌트 번호가 그대로 채널 ID가 된다.
4. import freud
입자 시뮬레이션 데이터를 분석하는 라이브러리로, 이웃 탐색이 빠르고 PBC를 지원한다.
- 채널 용매 원자 좌표로 AABB 트리 기반 공간 탐색 구조를 만든다.
- 나머지 원자마다 가장 가까운 채널 용매 원자 하나를 찾는다.
- 결과를 (질의 원자, 이웃 원자) 쌍 목록으로 바꾼다.
원자가 많아서 전체 거리 행렬을 계산하면 매우 느리기 때문에, freud의 공간 분할 탐색을 쓰는 것이다.
# Step 1: Generate copies of the initial channels
Step 1에서는 RNA가 들어있는 inverse-hexagonal (H_II) 지질 채널 1개를 만들고, 이를 2 X 2로 복제해 4채널 시스템을 만든 뒤 에너지 최소화까지 진행한다. 이 결과물인 m.gro 는 이후 과정의 입력이 된다.
노트북을 살펴보면 GROMACS genconf 에 대해서 친숙하지 않으면 다음 과정을 진행하지 말라는 경고문이 있다.
## Importat note: Please do not proceed if you are not familiar with GROMACS genconf.
### You can learn more about GROMACS genconf here: https://manual.gromacs.org/current/onlinehelp/gmx-genconf.html
GROMACS genconf 에 대해서는 아래 링크에서 자세히 알아볼 수 있다.
https://manual.gromacs.org/current/onlinehelp/gmx-genconf.html
gmx genconf - GROMACS 2026.4 documentation
Previous gmx gangle
manual.gromacs.org
- 채널 복제
!gmx genconf -f m.gro -nbox 4 4 1 -o 4x4x1_channels.pdb
! 는 Jupyter에서 셀 명령을 실행하라는 표시다.
gmx genconf는 입력 박스를 격자 모양으로 복사해서 붙인다.
- -f m.gro : Step 1에서 최소화한 4채널 시스템이 입력이다.
- -nbox 4 4 1 : x로 4번, y로 4번, z로 1번 복사한다. 결과는 16개 박스 X 4채널 = 64채널이다.
- -o 4x4x1_channels.pdb : 다음 셀에서 MDAnalysis로 읽을 수 있게 PDB로 저장한다.
64채널이나 만드는 이유는 나중에 육각형 모양으로 채널을 골라낼 때, 주기 경계(PBC)에 잘리지 않은 온전한 채널들이 충분히 있어야 하기 때문이다.
- 구조 읽기와 "채널 내부" 원자 선택
# Reading in the copied channels
universe = mda.Universe('4x4x1_channels.pdb')
selection_string = 'name W WF ION NA CL BB BB1 BB2 BB3 SC1 SC2 SC3 SC4 SC5 SC6 and not around 8 (name CA1 CB1 C3A C3B D3A D3B)'
selection = universe.select_atoms(selection_string)
- mda.Universe(...) : 64채널 구조 전체를 불러온다.
- 선택 문자열은 두 부분으로 나뉜다.
- name W WF ION NA ... SCG : 채널 안을 채우는 것들.
- and not around 8 (name CA1 CB1 ... D3B) : 위 원자들 중에서 지질 꼬리 비드 8 Å 이내에 있는 것은 제외한다. 지질 꼬리 쪽으로 세어 들어간 물 때문에 이웃 채널끼리 연결되어 보이는 것을 막으려는 조건이다.
- Containment 분석
# Checking if everything went alright
containers = mdvc.Containers(selection)
기본값은 resolution = 0.5 (nm), blur_amount = 1 이다.
- 복셀화 : 박스를 0.5 nm 격자로 나누고, 선택된 원자가 있는 칸은 "채움", 없는 칸은 "빔"으로 표시한다.
- blur : 채운 영역을 한칸씩 부풀려서 원자 사이의 작은 틈을 메운다.
- 라벨링 : scipy.ndimage.label 로 서로 연결된 덩어리마다 번호를 붙인다. 선택된 쪽(채널 용매와 RNA)은 양수 라벨, 선택되지 않은 쪽(지질 영역)은 음수 라벨이 붙는다.
- PBC 연결 : 박스 경계를 넘어 이어지는 덩어리는 하나로 합친다.
- 포함 그래프 : 어떤 덩어리가 어떤 덩어리를 감싸는지를 그래프 (containment_graph)로 만들고, 각 노드에 해당 원자들 (AtomGroup)을 붙인다.
- 결과 확인
print(f'The children of the lipids outside are: {containers.get_children_components([-1])}')
containers.plot() # Everything seems as expected (64 channels)
- get_children_components([-1]) : 라벨 -1 은 선택되지 않은 영역, 즉 지질 매트릭스다. 그 바로 아래 단계의 자식, 다시 말해 지질이 직접 감싸고 있는 컴포넌트들을 반환한다. 이것이 바로 채널들이다.
- 정상이라면 양수 번호 64개가 출력되어야 한다.
- 64개보다 적으면 채널끼리 붙은 것이고, 많으면 채널이 쪼개졌거나 작은 물 덩어리가 따로 잡힌 것이다.
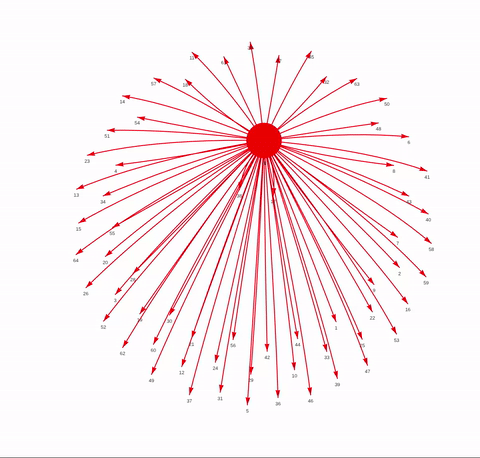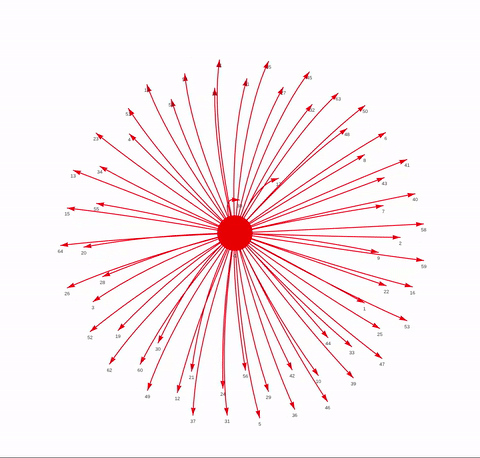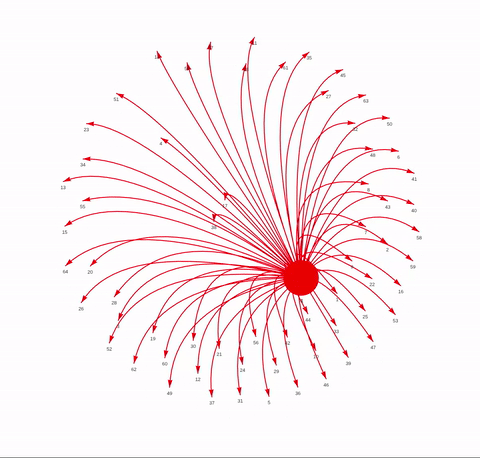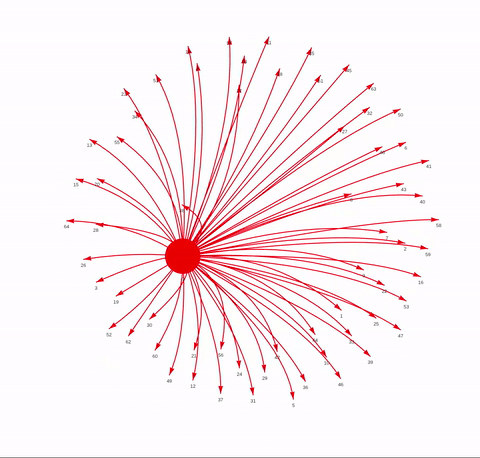
- containers.plot() : 포함 관계 그래프를 pyvis 인터랙티브 HTML로 그린다. 폴더에 있는 containment.html 이 이전에 이렇게 생성되었다. 지질 노드 하나에 채널 노드 64개가 매달린 별 모양이면 정상이다.
아래는 생성된 containment.html을 열어본 결과이다.
# Step 2: An expensive but simple way to get the hexagon
Step 2에는 다음과 같은 주석이 있다.
We do not reuse any labeling we had and just create new labels.
Then we select the IDs that we want and write them to disk.
이 단계는 복제한 64채널 시스템의 모든 원자에 "몇 번 채널 소속인지" 번호(1-64)를 붙이는 단계이다.
이후 이어지는 Step 3에서 육각형 모양으로 채널을 골라내려면 이 번호가 먼저 있어야 한다.
제목에 expensive 라고 붙은 이유는, 앞서 만든 라벨을 재사용하지 않고 21만 원자 전체를 처음부터 다시 라벨링 하기 때문이다.
- 컴포넌트를 지질과 채널로 나누기
# Get all components
components = containers.get_components()
# Get the lipid components by appreciating they are the outside
lipid_components = containers.get_root_components()
# Get the solvent components by appreciating they are not an outside
solvent_components = sorted(set(components) - set(lipid_components))

print(f'Lipid components: {lipid_components}\nSolvent components: {solvent_components}')- get_component() : containment 그래프의 노드 번호를 모두 가져온다.
- get_root_components() : 들어오는 화살표가 없는 노드, 즉 아무도 감싸지 않는 가장 바깥 컴포넌트이다. 여기서는 [-1], 지질 매트릭스이다.
- solvent_components : 전체에서 root를 뺀 나머지를 정렬한 것이고, 채널 64개 이다.
- 변수 이름이 lipid, solvent 이지만, 실제로는 "바깥 영역"과 "그 안에 감싸인 영역"이라는 구조로 나눈 것이다. 이 시스템에서는 둘이 각각 지질과 채널에 해당한다.
- 컴포넌트별 원자 묶음 꺼내기
# Appreciate that the atomgroups are bound to the nodes in the containment graph
lipid_atomgroups_dict = dict(zip(lipid_components, [containers.containment_graph.nodes(data=True)[component]['atoms'] for component in lipid_components]))
solvent_atomgroups_dict = dict(zip(solvent_components, [containers.containment_graph.nodes(data=True)[component]['atoms'] for component in solvent_components]))

print(f'Lipid atomgroups: {lipid_atomgroups_dict}\nSolvent atomgroups: {solvent_atomgroups_dict}')- containment 그래프의 각 노드에는 'atoms' 속성으로 그 영역에 속한 원자들(MDAnalysis AtomGroup)이 붙어 있다.
- dict(zip(...))로 {컴포넌트 번호: AtomGroup} 형태의 딕셔너리 두 개를 만든다.
- 주의할 점 : 이 원자 묶음은 앞서 선택한 문자(물/이온/RNA) 만으로 이루어진 게 아니다. 복셀 기준으로 그 영역 안에 들어간 원자는 모두 포함된다.
- query_neighbors 함수
def query_neighbors(A, B, num_neighbors=1, exclude_ii=True):
    """
    Returns the closest index A with respect to B using the universe indices.

    A and B are atomgroups. Exclude_ii excludes the self contact.
    """
    universe = A.universe
    # Create the Freud AABB data structure for each solvent atomgroup
    box = mdvc.containment.Periodic(universe.dimensions)
    aq = freud.locality.AABBQuery(box.pbc_freud, A.positions)
    # Query the lipids against the solvent atomgroup
    query_results = aq.query(B.positions, dict(num_neighbors=num_neighbors, exclude_ii=exclude_ii))
    # Return the atom indcices and not the index in the list (TODO)
    output = np.array(query_results.toNeighborList())
    output[:,0] = B[output[:,0]].ix
    output[:,1] = A[output[:,1]].ix
    return output
"B의 각 원자에 대해 A에서 가장 가까운 원자를 찾아라" 를 PBC까지 고려해서 빠르게 수행하는 함수이다.
box = mdvc.containment.Periodic(universe.dimensions)
MDAnalysis 형식의 박스 정보 [a, b, c, α, β, γ]를 Periodic 객체로 감싼다.
pbc_freud로 꺼내면 freud가 쓰는 3×3 박스 행렬이 된다.
aq = freud.locality.AABBQuery(box.pbc_freud, A.positions)
A(기준점) 좌표로 AABB 트리를 만든다.
공간을 상자 계층으로 나눠 두는 구조라서, 가까운 점을 전체 비교 없이 빠르게 찾을 수 있다.
query_results = aq.query(B.positions, dict(num_neighbors=1, exclude_ii=True))
B의 원자마다 A에서 가장 가까운 원자 1개를 찾는다.
거리 제한 없이 무조건 1개를 찾는다.
output = np.array(query_results.toNeighborList())   # [[B 내부 순번, A 내부 순번], ...]
output[:,0] = B[output[:,0]].ix
output[:,1] = A[output[:,1]].ix- freud는 0부터 시작하는 각 그룹 안의 순번을 돌려준다. 이를 universe 전체 기준 인덱스(.ix)로 바꾼다.
- 반환값은 N X 2 배열이고, 각 행은 [B 원자 ix, 가장 가까운 A 원자 ix] 이다.
- 가장 가까운 채널 원자 찾기
# Get the closest solvent index for every lipid atom.
contacts = query_neighbors(selection, universe.atoms-selection, exclude_ii=True)
print(contacts)- A = selection(채널 안의 물/이온/RNA), B = 나머지 원자 전체
- B의 원자마다 A에서 가장 가까운 원자 1개를 찾고, 두 원자 모두 universe 인덱스(ix)로 돌려준다.
- 출력 예시 : [357 1397] 은 357번 원자에서 가장 가까운 채널 원자는 3197번이라는 뜻이다.
- 주석에는 "lipid atom"이라고 되어 있지만, 실제 B에는 지질뿐 아니라 꼬리 근처라서 선택에서 빠진 물/이온/RNA 비드도 들어 있다.
- 원자 번호 → 채널 번호 대응표
# Create a mapping dict which maps every solvent index to a component ID.
ix_solventID_dict = {}
for solvent_component in solvent_components:
    for atom in solvent_atomgroups_dict[solvent_component]:
ix_solventID_dict[atom.ix] = solvent_component- 채널 1 ~ 64의 원자 묶음을 돌면서 {원자 ix: 채널 번호} 딕셔너리를 만든다.
- 채널 원자 묶음에는 선택한 원자뿐 아니라 그 복셀 안에 있는 원자도 포함된다. 그래서 이 딕셔너리는 이전 셀에서 찾은 "가장 가까운 원자" 보다 넓은 범위를 담고 있다.
- 원자 번호를 채널 번호로 바꾸기
# Replace the closest solvent atom with the closest solvent component ID.
component_contacts = contacts.copy()
component_contacts[:,1] = np.vectorize(ix_solventID_dict.get)(component_contacts[:,1])
#print(component_contacts)- contacts의 두 번째 열 (가장 가까운 채널 원자 ix)을 이전 셀의 딕셔너리에 넣어 채널 번호로 바꾼다.
- np.vectorize(dict.get)은 배열의 각 원소에 dict.get을 적용하는 방법이다.
- 결과 예시 : [357 2]는 357번 원자가 채널 2와 가장 가깝다는 뜻이 된다.
- 이 셀은 실패할 수 있다. 선택된 원자 중 어느 채널 컴포넌트에도 들어가지 않은 원자(예를 들어 -1 영역 복셀에 떨어진 원자)가 있으면 .get이 None을 돌려주고, 정수 배열에 넣다가 TypeError가 날 수 있다. 하지만, 4채널에서는 문제 없었으므로 64채널에서도 괜찮을 가능성이 크고, 실제로도 문제가 없었다.
- 원자 ix → 채널 번호 딕셔너리
# Map the lipid indices to a component ID
lipidix_solventID_dict = dict(zip(component_contacts[:,0], component_contacts[:,1]))
#lipidix_solventID_dict- 두 열을 묶어 {비선택 원자 ix: 가장 가까운 채널 번호}를 만든다. 예를 들어 {357: 2, 358: 2, 364: 4, ...} 이다.
- 각 원자는 이웃을 정확히 1개만 찾으므로 키가 중복되거나 덮어써지는 경우는 없다.
- 이 딕셔너리는 다음 셀의 residue 다수결에 쓰인다.
- 다수결 대상 준비
# Determine the dominant nearest component per residue (to make sure they are whole).
leftovers = universe.atoms - selection- 채널로 선택되지 않은 원자 전체이다. 이전 셀의 B와 같은 원자 집합이다.
- 다음 셀에서는 leftovers.residues, 즉 이 원자들이 속한 분자 단위로 반복한다.
- residue 마다 다수결로 채널 정하기
dominant_component_per_residue = {}
for residue in leftovers.residues:
    components = {}
    for component in solvent_components:
        components[component] = 0
    for atom in residue.atoms:
        try:
            components[lipidix_solventID_dict[atom.ix]] += 1
        except KeyError:
            continue
    # We do not want to assign a component if they are all 0.
    if sum(components.values()) == 0:
        continue
dominant_component_per_residue[residue.ix] = max(components, key=components.get)- 예를 들어 MC3H 한 분자(비드 12개)에서 10개가 채널 2를, 2개가 채널 5를 가리키면 그 분자는 채널 2로 정해진다.
- 이렇게 하는 이유는 원자 단위로 나누면 한 분자가 두 채널에 걸쳐 잘릴 수 있기 때문이다. 분자 단위로 통일해야 나중에 채널을 골라낼 때 분자가 온전하게 남는다.
- 결과는 {residue ix: 채널 번호} 딕셔너리다.
- 표가 동점이면 max가 먼저 나온 키를 고르므로, 번호가 작은 채널로 정해진다.
- residue 마다 채널 64개짜리 딕셔너리를 새로 만드는 파이썬 반복문이라, 64채널 시스템에서는 시간이 좀 걸린다.
- leftovers.residues 에 포함된 residue 는 적어도 원자 하나가 leftovers에 속한다.
- leftovers의 원자는 모두 이웃을 1개씩 찾았으므로, 표가 0개인 residue는 생길 수 없다.
- 따라서 sum == 0 으로 건너뛰는 분기는 실제로 실행되지 않고 안전장치로써 기능한다.
- 라벨 배열 만들기
# Make the label array for the complete universe
universeix_components = np.zeros(len(universe.atoms))- 전체 원자 수만큼의 배열을 0으로 채운다. 64채널에서는 210,240칸이다.
- 0은 "아직 배정 안됨" 이라는 뜻이다. 채널 번호가 1부터 시작하므로 0과 겹치지 않는다.
- np.zeros의 기본 자료형은 float 이라서 값이 1.0, 2.0 처럼 저장된다. 나중에 int로 바꿔준다.
- 채널 원자부터 채우기
# Fill in the known components
for component in solvent_components:
universeix_components[solvent_atomgroups_dict[component].ix] = component- 채널 1 ~ 64 각각의 원자 묶음 위치에 그 채널 번호를 써 넣는다.
- 채널 원자 묶음은 복셀 기준이라 선택한 원자 외에 채널 복셀에 걸친 일부 원자도 포함한다.
- 지질 영역(-1)의 원자는 여전히 0으로 남는다.
- 확인하기
# Quick sanity check, indeed we have assigned all the solvent components now
dict(zip(*np.unique(universeix_components, return_counts=True)))- 라벨 값마다 원자 수를 센다.
- 0의 개수가 지질 영역(-1) 원자 수와 정확히 같고, 전체 원자 수와도 맞는지 확인한다.
- 특정 채널만 개수가 크게 다르다면, 그 채널이 박스 경계에서 잘렸거나 containment 결과가 이상한 것이다.
- 다수결 결과로 덮어쓰기
# Add all the non solvent label based on their closest dominant residue component per residue.
for residue in leftovers.residues:
universeix_components[residue.atoms.ix] = dominant_component_per_residue[residue.ix]- 정한 채널 번호를 해당 residue의 모든 원자에 쓴다.
- 그래서 아직 0으로 남아 있던 지질 원자와 이미 번호를 받았던 원자(같은 분자 안에 선택된 원자가 섞여 있었거나, 채널 복셀에 걸쳐 있던 원자)도 모두 분자 기준 번호로 덮어써진다.
- 이 셀을 거치면 한 분자 안의 원자는 모두 같은 번호를 갖는다.
- 반대로 처음부터 전부 선택된 residue, 예를 들어 채널 한가운데에 있는 W 비드 하나나 CL 이온 하나는 leftovers에 없으므로 기존 번호가 그대로 유지된다.
- 최종 확인
# Quick sanity check, indeed we have assigned all the non solvent components now.
dict(zip(*np.unique(universeix_components, return_counts=True)))- 정상인지 판단하는 기준은 두 가지인데, 하나는 0이 없어야 한다는 것이고 나머지는 채널마다 정확히 3,285개여야 한다는 것이다. 0이 없다는 것은 배정되지 않은 원자가 없다는 뜻이다. 3,285개는 채널 1개 분량으로, RNA 1개, 지질 209개, W 529개, CL 98개를 합한 수이다.
- 64채널에서는 1~64 모두 3,285 개가 나와야 하고 * 64를 했을 때 전체 원자 수와 같아야 한다.
- 어떤 채널이 3,285 보다 많고 이웃 채널이 그만큼 적다면, 경계에 있던 분자가 이웃 채널로 잘못 배정된 것이다.
- clusters.npy 저장
# We can now write this as a labeling array which can be used by mdvwhole
universeix_components = np.array([universeix_components], dtype=int) # it expects an array for every frame
np.save('clusters.npy', universeix_components)- 대괄호로 한 번 더 감싸서 모양을 (N,)에서 (1, N)으로 바꾼다. 즉 (프레임 수, 원자 수) 형태이다. mdvwhole이 "프레임마다 라벨 배열 하나"를 기대하기 때문이고, 여기서는 단일 구조라 프레임이 1개다.
- dtype=int로 float(2.0)을 정수(2)로 바꾼다.
- mdvwhole은 이 라벨을 보고 같은 번호의 원자 묶음을 PBC 경계를 넘어 하나로 이어 붙인다(make whole).
- Step2_channel_extraction.ipynb 의 clusters.npy(4채널)를 덮어씁니다.
- components.pdb 저장
# Write the labeled universe as a PDB
universe.add_TopologyAttr('tempfactors')
universe.atoms.tempfactors = universeix_components[0]
universe.atoms.write('components.pdb')- add_TopologyAttr('tempfactors') : universe에 beta(B-factor) 속성을 추가한다. PDB에서 읽어 이미 있으면 그대로 둠.
- universeix_components[0] : (1, N) 배열에서 첫 프레임을 꺼내 각 원자의 beta 값으로 넣는다.
- .write('components.pdb') : beta 열에 채널 번호가 기록된 PDB로 저장한다. 이 파일도 Step2 .ipynb 결과를 덮어쓴다.
- 원자가 21만 개라서 PDB 형식의 자릿수 제한(원자 번호 5자리, residue 번호 4자리)을 넘는다. 번호가 잘려 기록되거나 경고가 나올 수 있지만 다음 단계에서는 beta 값으로 선택하므로 문제되지 않는다.
- 확인하기
universe.atoms.tempfactors- beta 값이 제대로 들어갔는지 배열로 확인한다.
- 원자 순서대로 채널 번호가 보이면 정상이다.
# Step 3: Select the channels that you want in VMD using the beta field and write the PDB
# Load in the components.pdb into VMD or Chimera or similar.
# Color the channels according to beta value
# Then you can make a selection of the correct channels by selection via beta value

# Then save the selection as Hexagon.pdb
components.pdb를 VMD에 불러와 Coloring Method를 Beta로 설정하면 채널마다 다른 색으로 보인다.
육각형을 이루는 채널 번호를 확인한 뒤 저장한다.
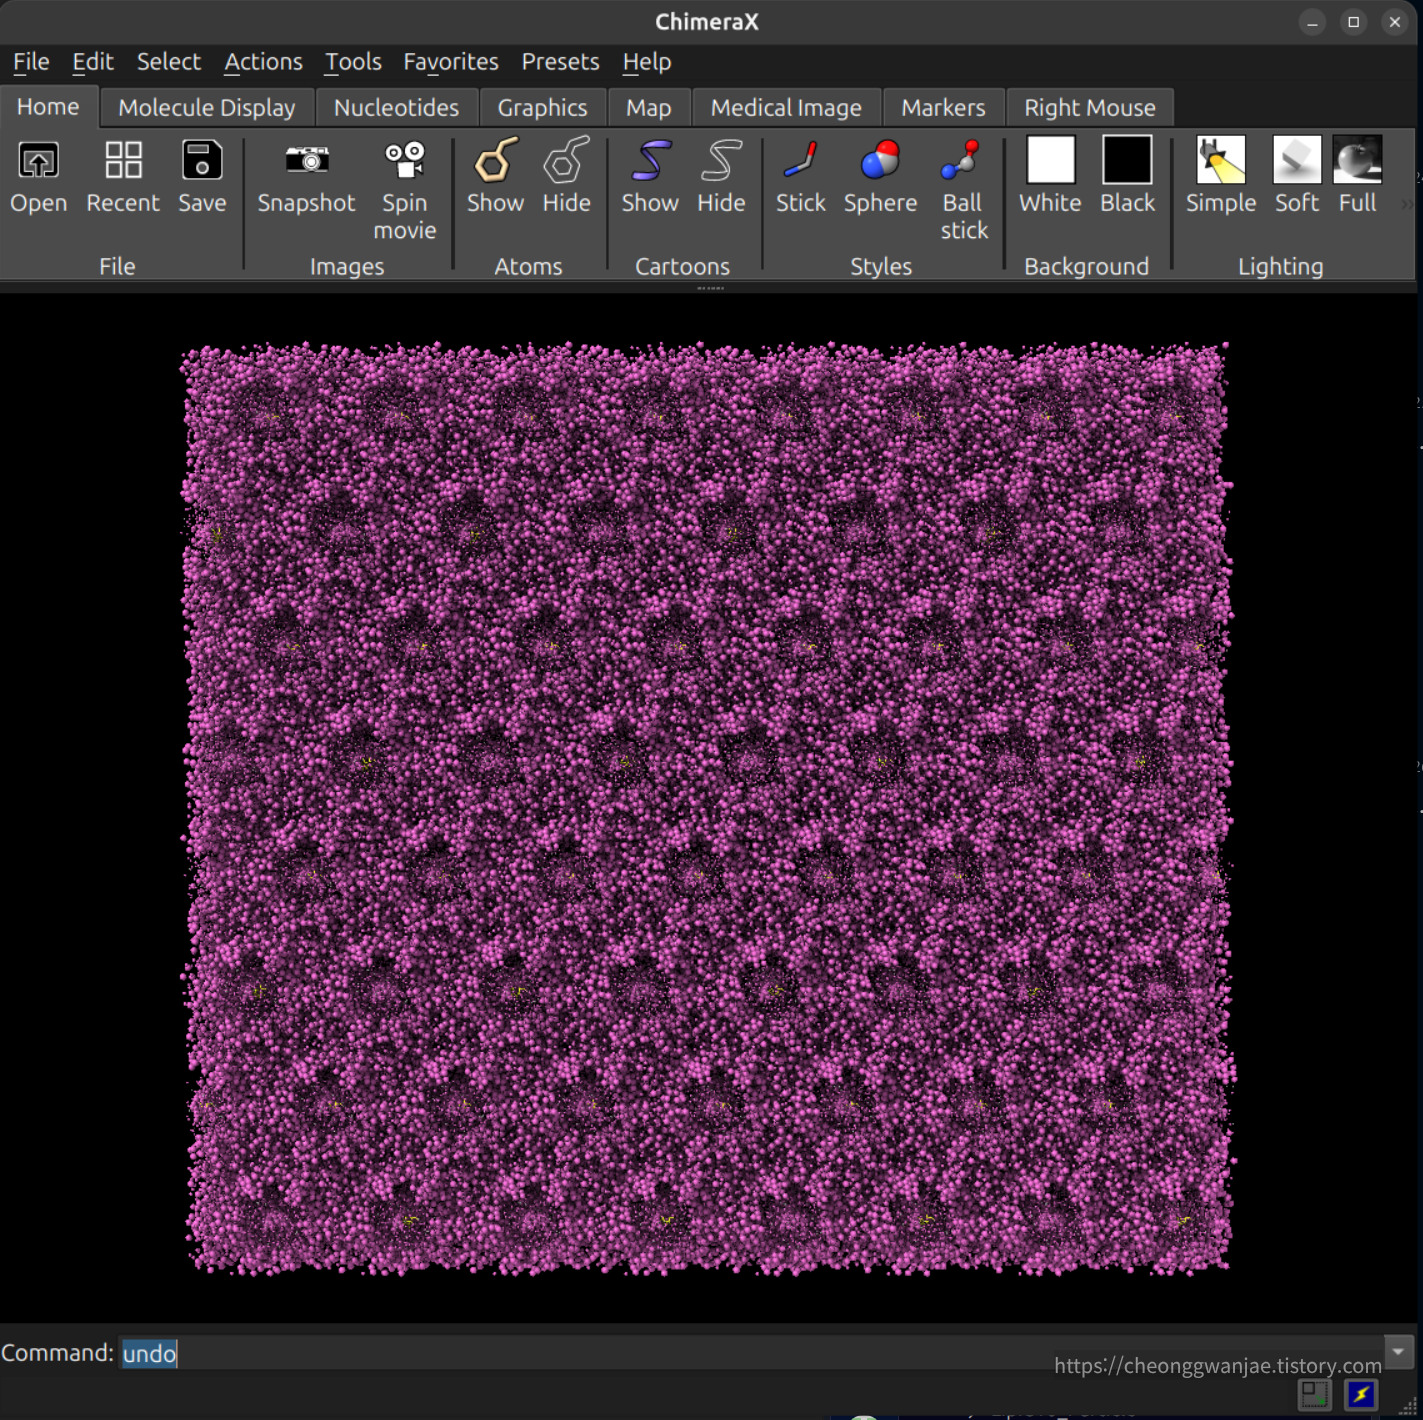
ChimeraX 하단의 Command 창에 입력한다.
open components.pdb
style sphere
color bfactor palette rainbow range 1,64
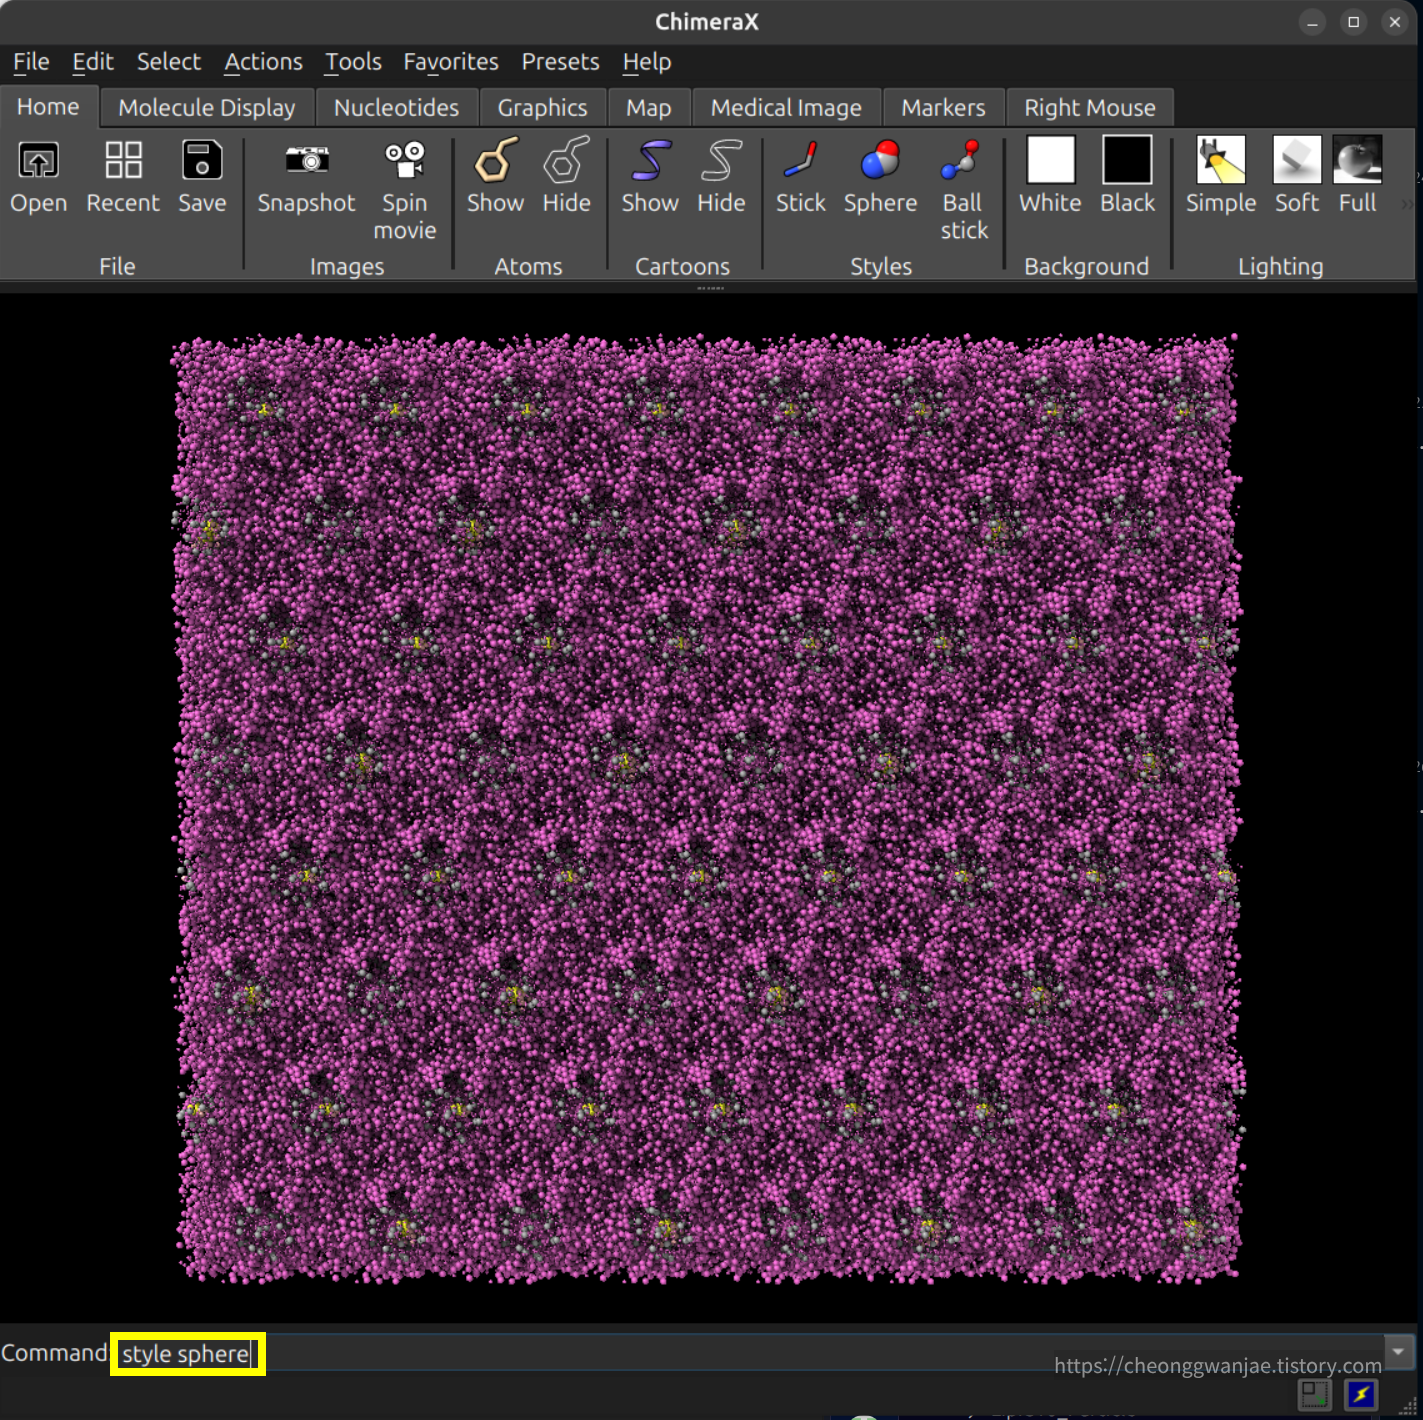
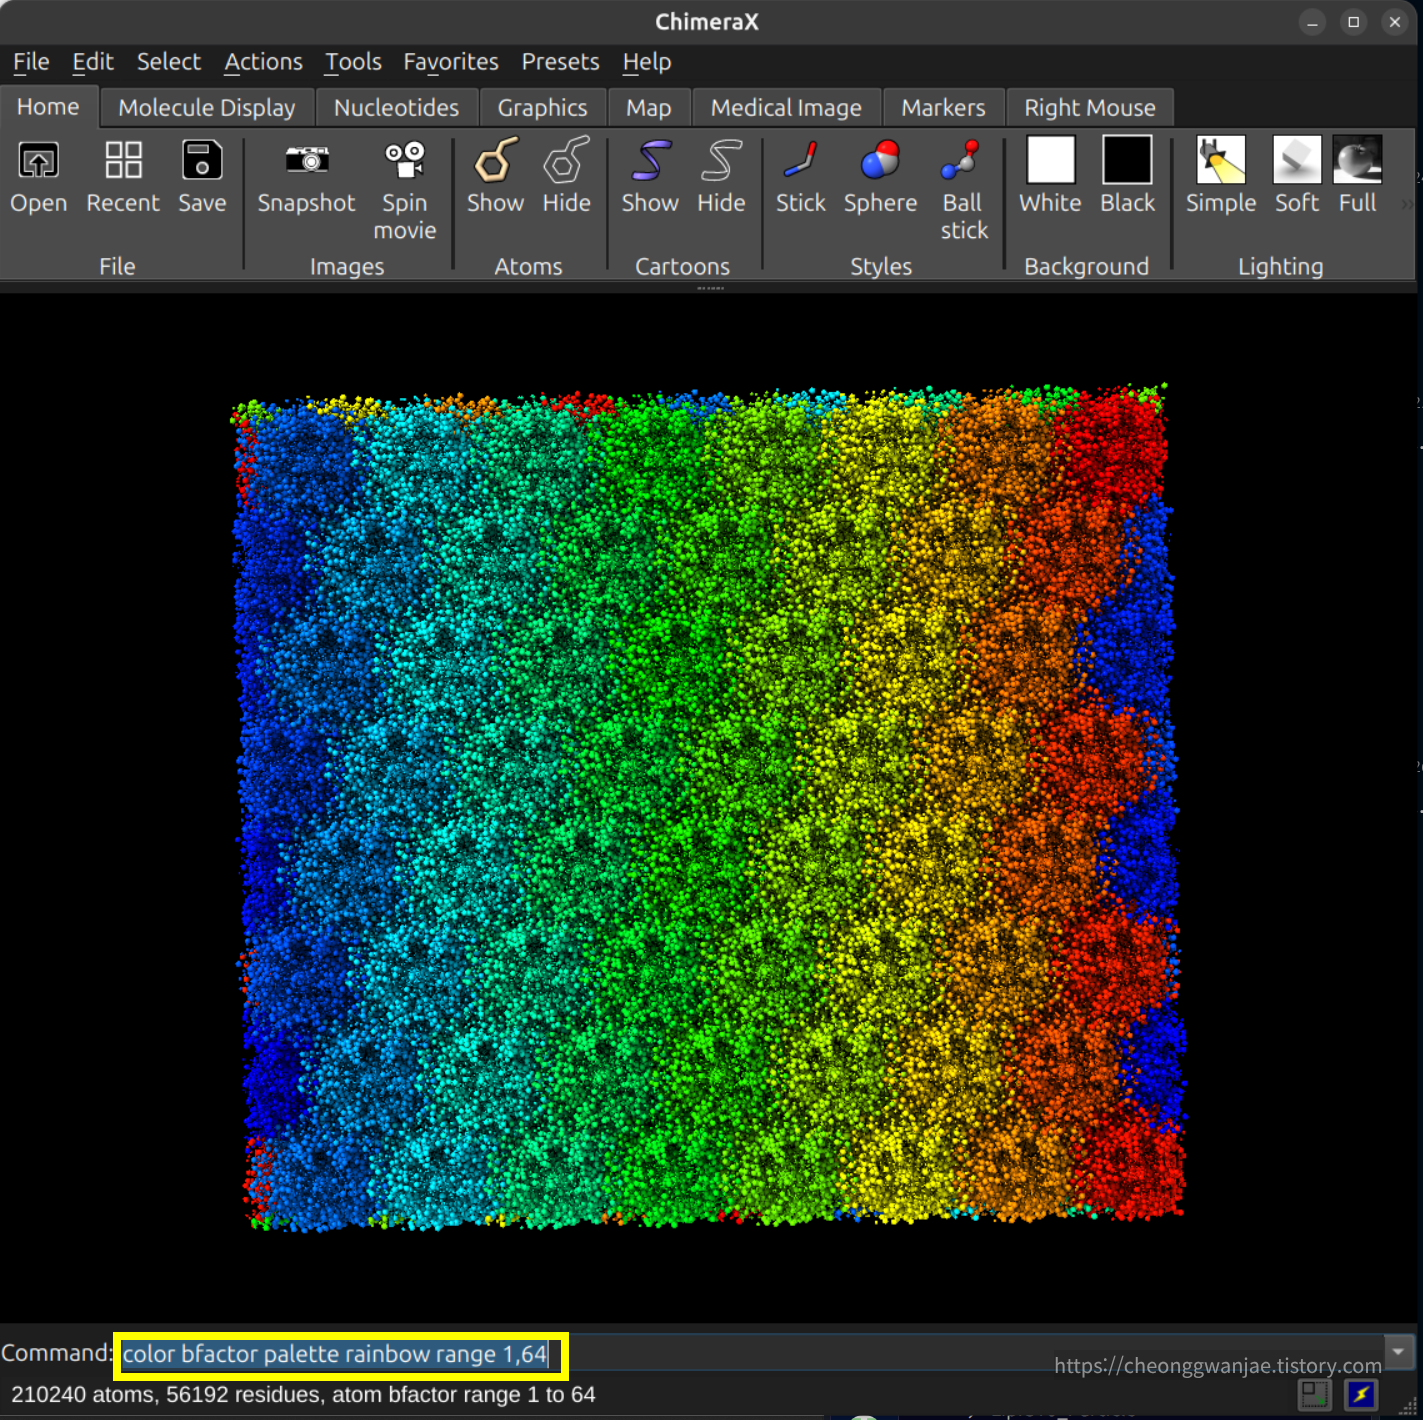
그 다음 아래 코드를 커맨드에 입력해서 육각형 채널을 선택한다.
select @@bfactor=45 | @@bfactor=37 | @@bfactor=41 | @@bfactor=42 | @@bfactor=49 | @@bfactor=50 | @@bfactor=53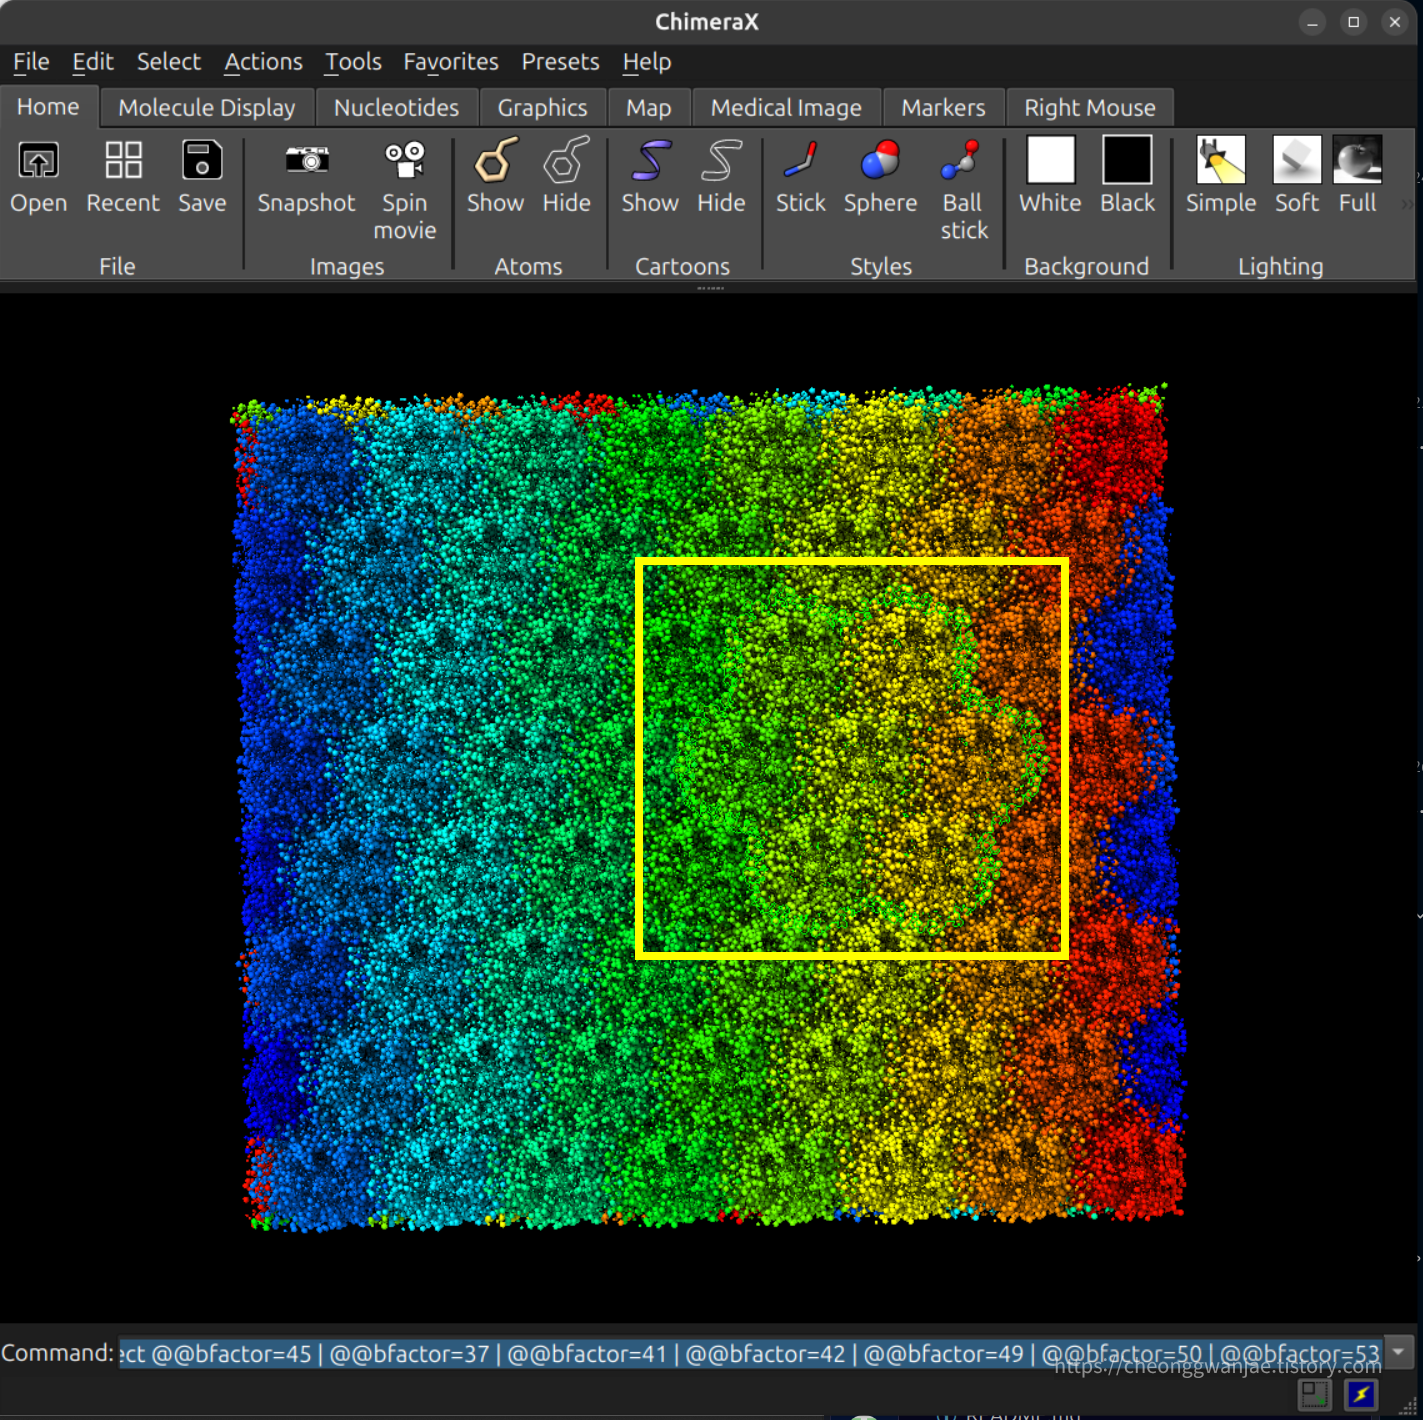
선택된 채널이 초록색 테두리로 표시된다.
육각형 모양인지 눈으로 확인해준다.
이제 선택한 원자만 저장해준다.
save ~/경로/Hexagon.pdb selectedOnly true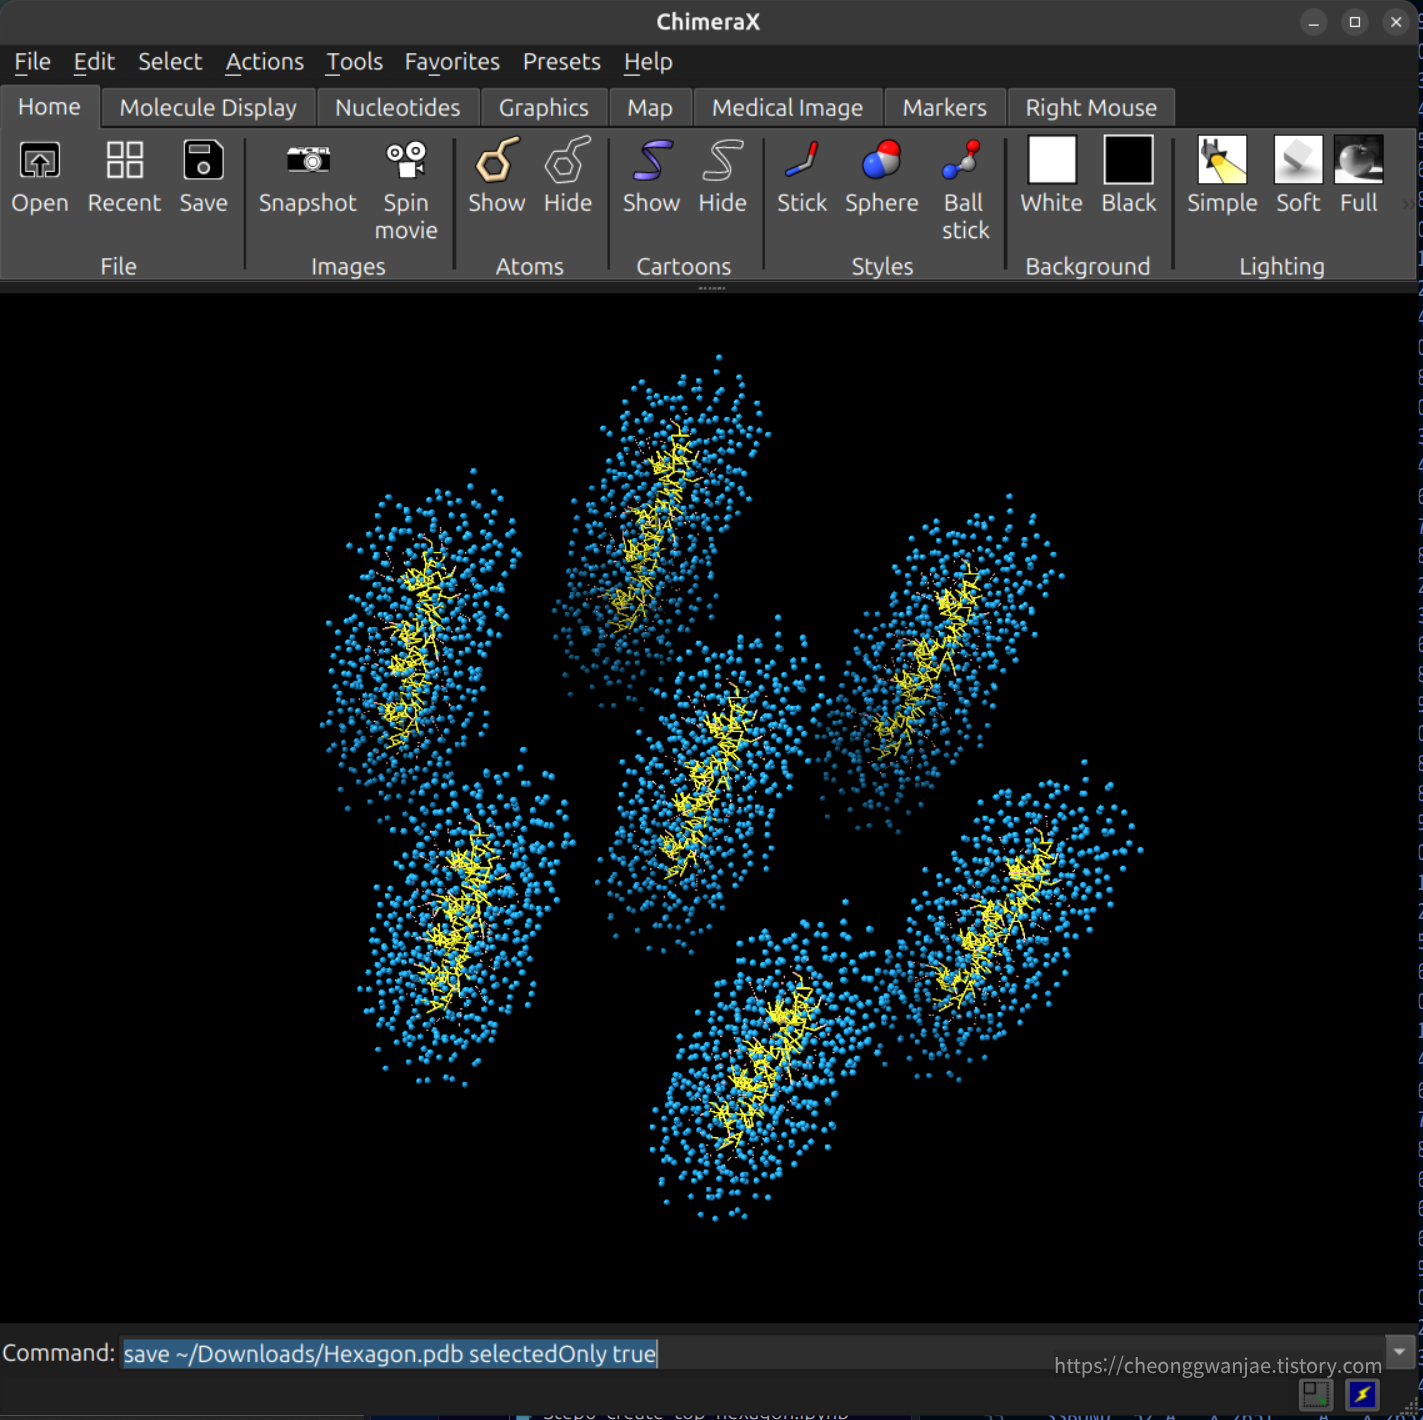
어라? 지질이 없다.
그리고 문제는 ChimeraX로 저장되면서 SSBOND, CONECT 등의 내용이 추가되었는데 이는 CG 비드 이름(BB, SC1)을 붕소(B)와 황(S)으로 잘못 추측해서 가짜 결합 정보가 생성된 것이다.
이를 해결하기 위해 그냥 Step3의 노트북 파일에 아래 코드를 추가하고 실행한다.
hexagon_ids = [45, 37, 41, 42, 49, 50, 53]
hexagon = universe.atoms[np.isin(universe.atoms.tempfactors.astype(int), hexagon_ids)]
print(len(hexagon), len(hexagon) == 3285 * len(hexagon_ids))
hexagon.write('Hexagon.pdb')
이러면 해당 노트북 디렉토리에 Hexagon.pdb 가 생성된다.
이제 드디어 3번째 노트북 파일 내용이 끝났다!!!!!
이제... 4번째 노트북으로 넘어가보겠다....ㅠ
끝....